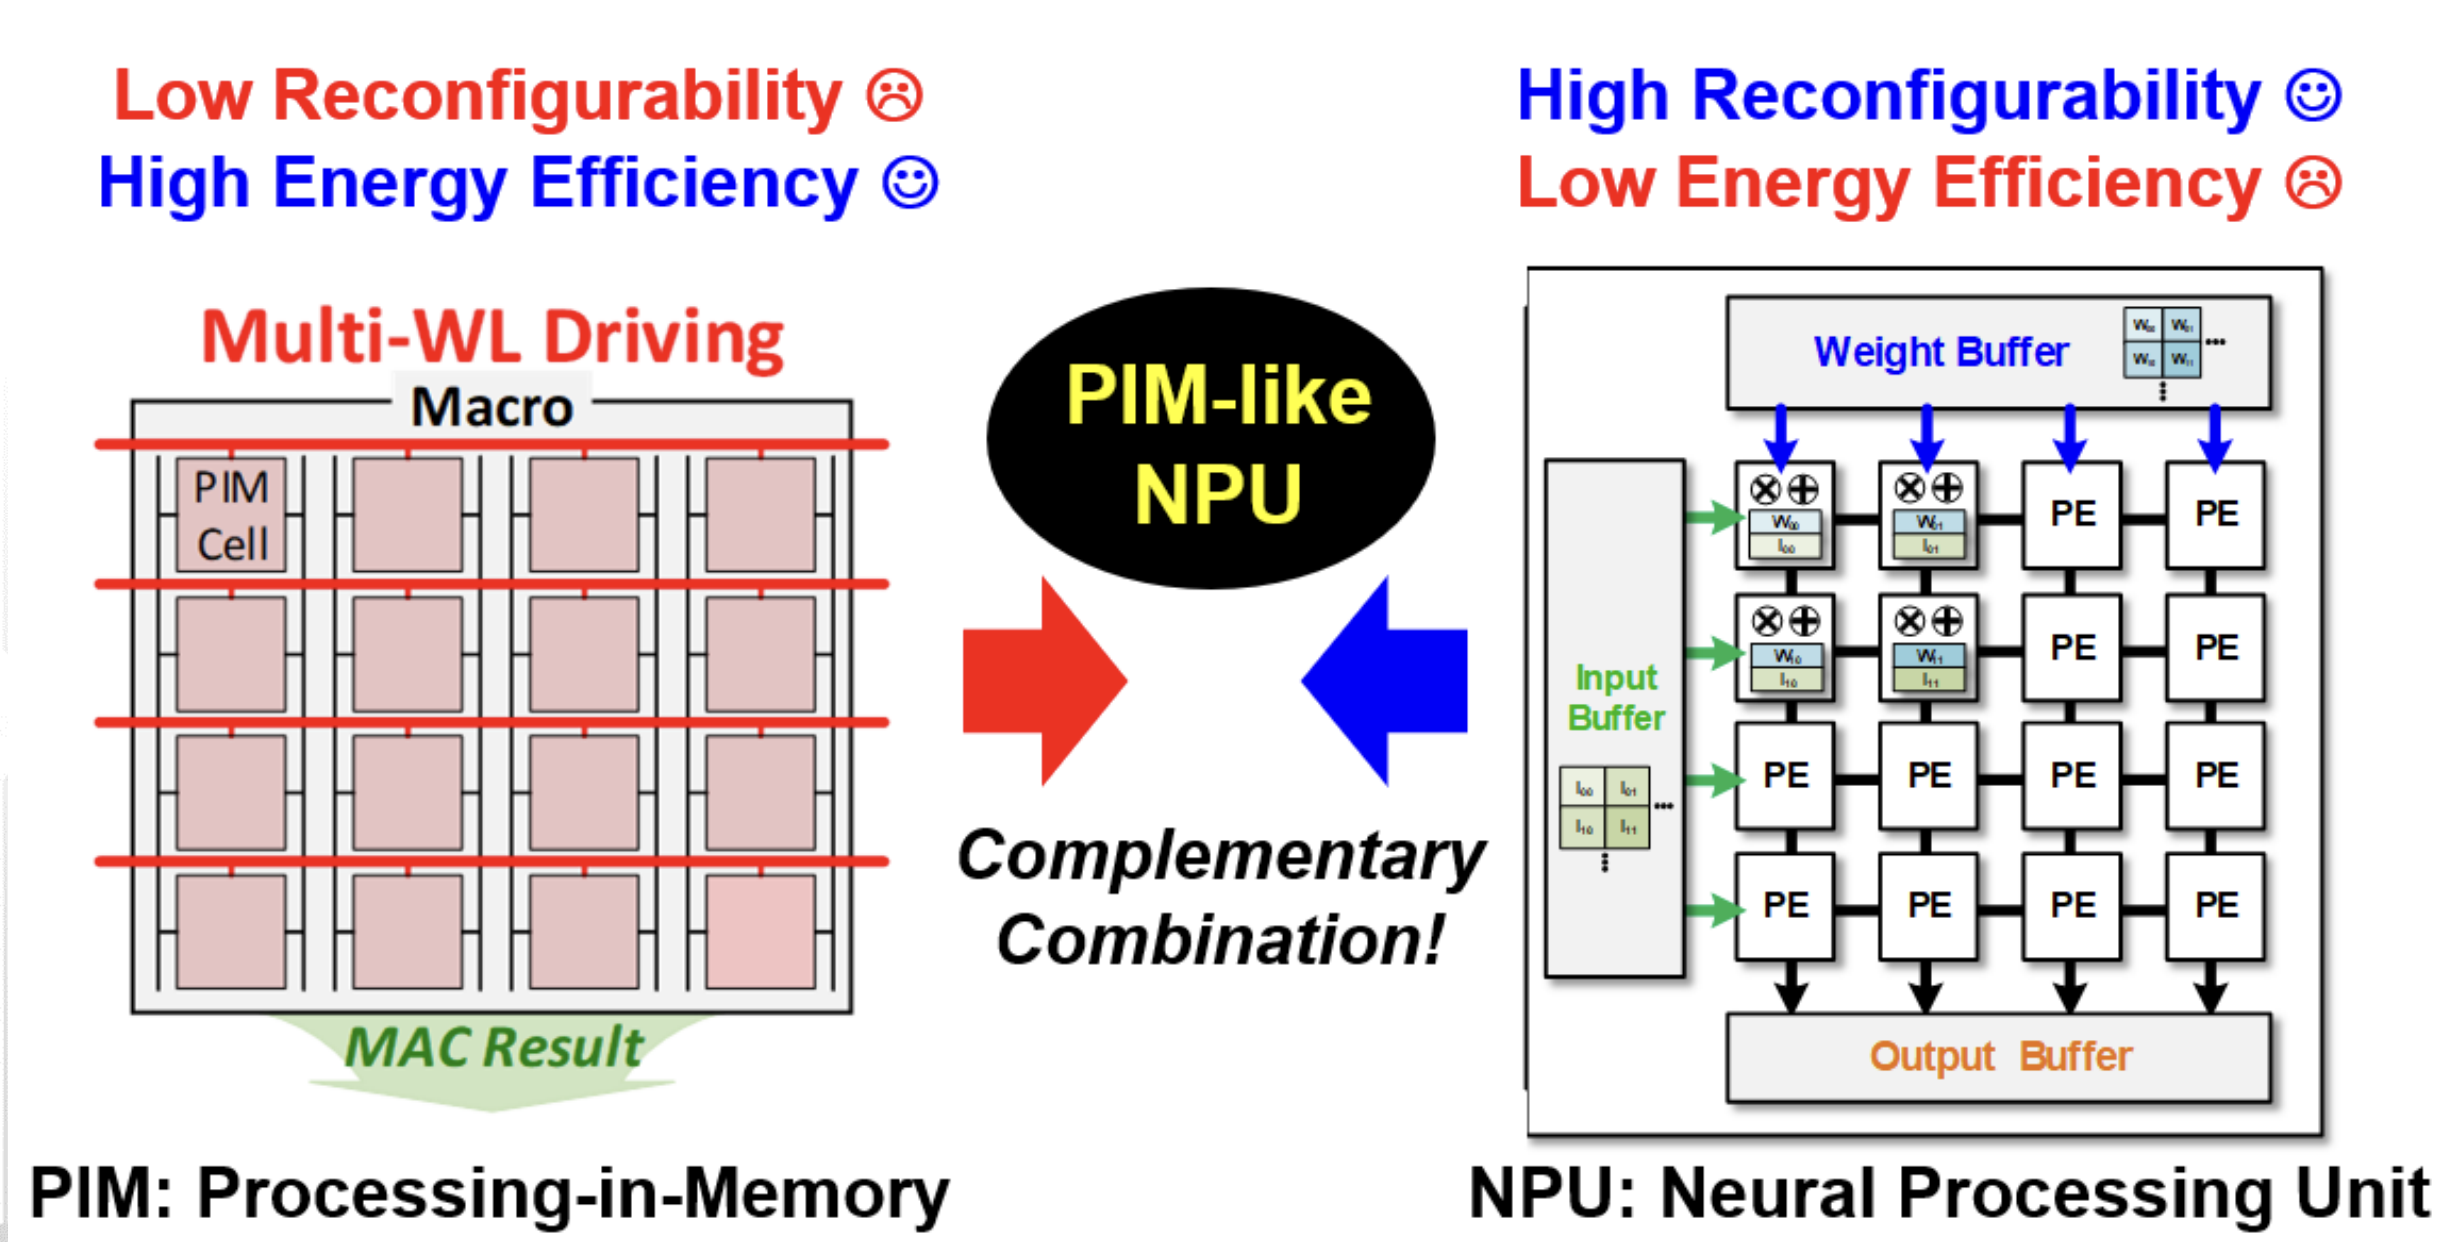
 PIMのエネルギー効率とNPUの再構成性を組み合わせたPIM-like NPUの概念図
用途に合わせて構成するNPU IP
PIM-like NPU IPはSemuniteのCore技術です。ComputeとMemoryを近くに配置し、Modelの要件に合わせてCompute、Data Movement、Memoryを構成します。
- Reconfigurable NPU
- WorkloadとCompute精度に合わせてPE arrayと複数Coreを構成します。
- Data control
- NPU内部のData Movementと実行を制御します。CPUとPeripheralの接続は、IPを適用するChipやSystemで構成します。
- Memory I/F
- ModelのInput、Weights、Output向けにMemory構造を構成します。外部Memoryの接続はChipとSystemの要件に合わせて設計します。
- Domain Accelerators
- SLMとVisionの拡張に向けて、Compression、Speculative decoding、Nonlinear functionのAccelerationを準備しています。
PIM(Processing-in-Memory)の低消費電力とNPUの高い再構成性を組み合わせた、相互補完型のArchitectureです。EDAによる自動Placement & Routingだけに頼らず、手作業のPhysical DesignでCompute UnitとMemoryを近接配置します。データ移動を最小化し、PPA最適化によって消費エネルギー、演算時間、Chip面積を削減します。
このCore NPU IPを適用した最初のChipは、Voice機能のSeM-V1です。
SeM-V1のChip ArchitectureとSpecificationsを見る
Zero-skippingでNPU IPを高度化
0値に伴う不要な演算をスキップする機能をNPU IPに追加しました。
Zero-skipping追加 · Tape-out前
今後のVUI AI Chipへの統合
更新したIPは、今後のVUI AI Chipに統合してTape-outする計画です。
VUI AI Chipへの統合 · 今後Tape-out予定
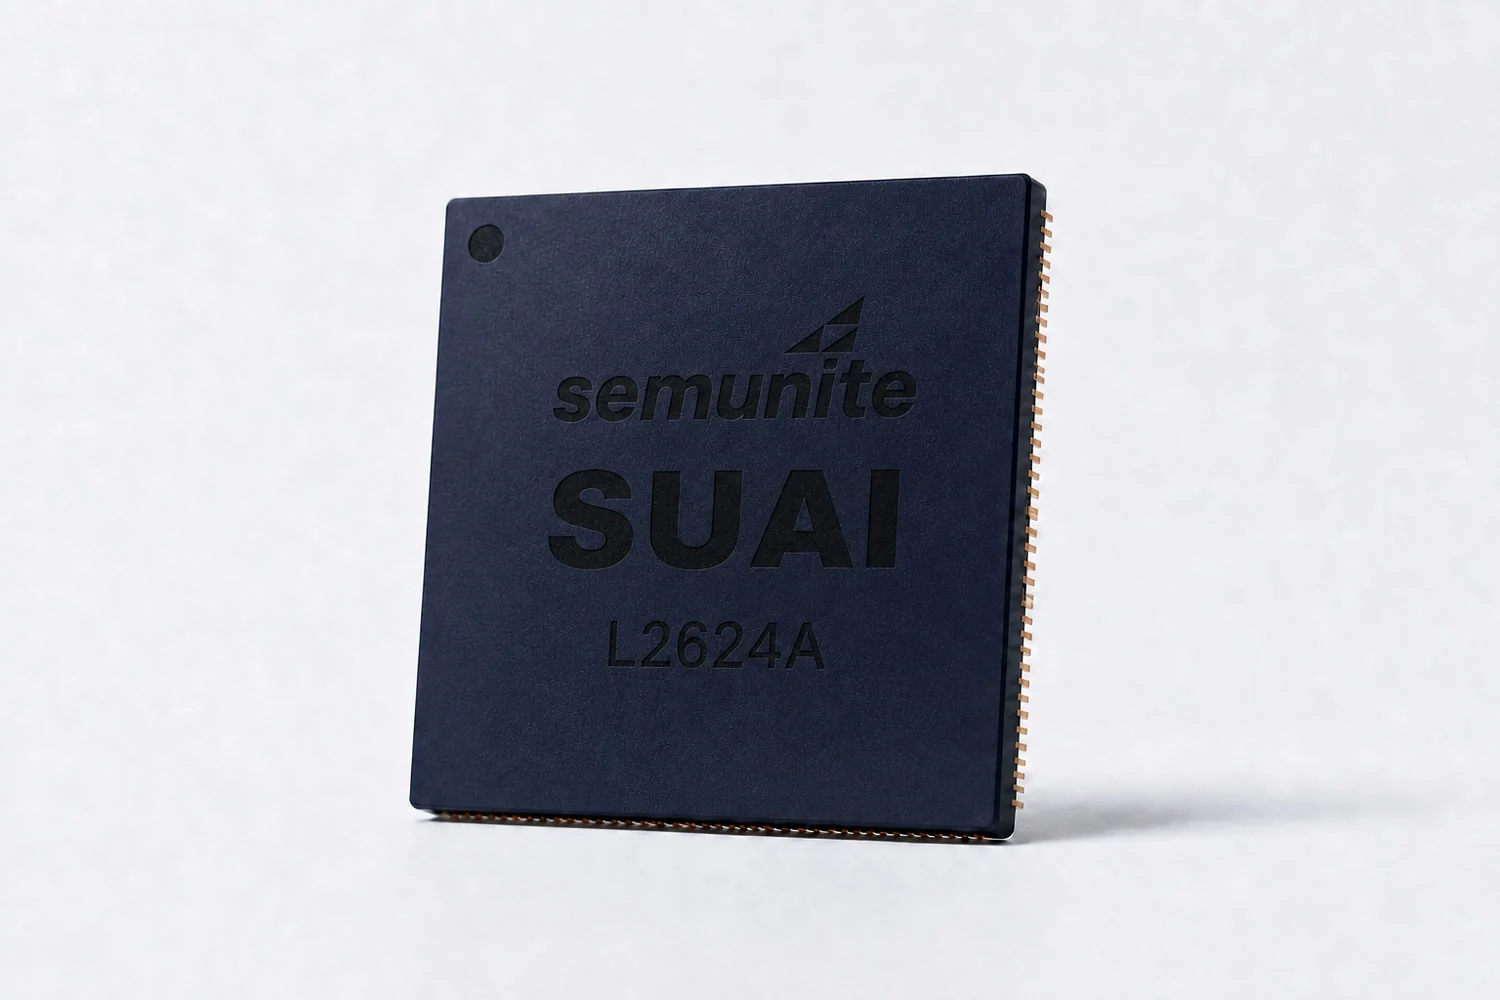
SUAI
PIM-like NPU検証用Test Chip
SUAIは2026年1月にTape-outを完了し、2026年6月に実Chipを入手しました。
- Peak · INT8
- 3.3 TOPS @ 200 MHz
- Peak · INT4
- 13.1 TOPS @ 200 MHz
- NPU cores
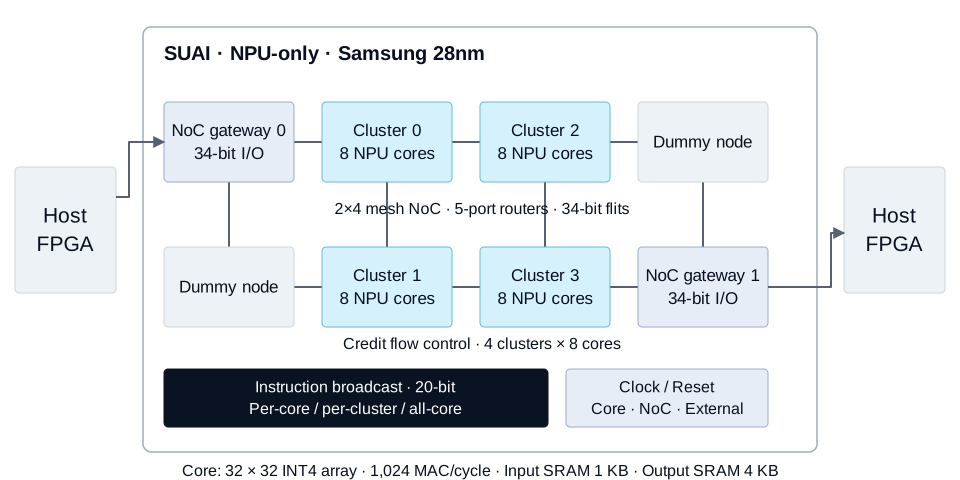
- 32 NPU cores · 4 clusters × 8 cores
- Process
- Samsung 28nm
32 Core全体のPeak Performance、200 MHzでの値です。INT8 ComputeはINT4 arrayで4回に分けて処理します。
SUAI ArchitectureとCore別PPAを見る
4 clusters × 8 coresと2×4 mesh NoCで構成するNPU-only Test Chipです。Diagramを大きく表示 (新しいタブで開きます)SUAI Core別PPA
- Peak / core · INT8
- 0.10 TOPS
- Power / core
- 16.1 mW
- Efficiency / core · INT8
- 6.4 TOPS/W
- Area / core
- 0.110 mm²
PIM-like array blockのCore別Peak値で、I/O SRAMを除きます。Synopsys PrimeTime PX、P&R netlist、Gate-level simulation activity、200 MHz、SS 0.9 V / −40 °C、MAC Utilization 100%、SPEF Parasitics未反映の条件です。
Model Mappingから実行まで
NPU IPをSeM-V1に適用するAI SDK開発Flowの例です。TFLite INT8 Modelを分析し、NPUとRISC-Vの実行につなぎます。
Trained model
TFLite INT8 Modelを準備
Analysis & mapping
LayerとQuantizationを分析し、NPU/RISC-Vの分担と4-core Scheduleを設定
C Runtime & Libraries
NPU/DMA Driver、Audio前処理、Host Protocol
Build
RISC-V GCCでELFを生成
Flash image
ELFとWeightsをQSPI Flashに配置
Runtime構成を見る
- Host application / Host library
- Host ApplicationとHost LibraryがUART/I2CでCommandとResult Packetを交換します。
- Audio pre-processing / Inference scheduler
- 512-point FFTとQ15 log-melの前処理から、4 NPU Cores + RISC-VのSchedulingにつなぎます。
- Bare-metal Runtime / Boot ROM
- Bare-metal RuntimeでBoot ROMがQSPI FlashからELFをロードし、NPU/DMA DriverとFlash Weight Streamingを実行します。
NPU IPの次の方向
SLMとVisionへのNPU IP拡張を準備しています。
Small Language ModelをOn-Deviceで実行するためのMemory ArchitectureとCompute最適化を準備します。
Flash Weight Streaming、HyperRAM KV Cache、Weight Compression、Speculative Decodingを検討します。
開発目標と検討Modelを見る
- 目標Model規模
- 0.5B-class
- 目標Throughput
- 20+ tokens/s
- Memory構成の方向
- Flash + HyperRAM
- 検討Model
- Qwen2.5-0.5B, Qwen3-0.6B
Compact Vision Model向けにMulti-core ComputeとMemory/Data Pathの拡張を準備します。
CNN/ViT Dataflow、Shared L2とTiling、HyperRAM、Camera Interfaceを検討します。
開発目標と検討Modelを見る
- 目標Compute Performance
- 0.5–2 TOPS (INT8)
- 目標Throughput
- 30+ fps
- Memory構成の方向
- Flash + HyperRAM
- 検討Model
- NanoDet, YOLOv8n, ShuffleNetV2, BlazeFace, MobileViT
上記の数値は将来の開発目標で、Model、Quantization、Memory、動作条件に合わせて具体化します。現在のNPU検証値はSUAIのSectionに別途表示しています。