NPU IP

연산과 메모리를 가까이, 필요한 연산에 집중.

세뮤나이트의 PIM-like NPU는 연산기와 메모리를 가까이 배치해 데이터 이동을 최소화합니다. 여기에 0값과 관련된 불필요한 연산을 건너뛰는 Zero-skipping 기능을 추가해 NPU IP를 고도화했습니다.

Zero-skipping 추가 · 테이프아웃 전

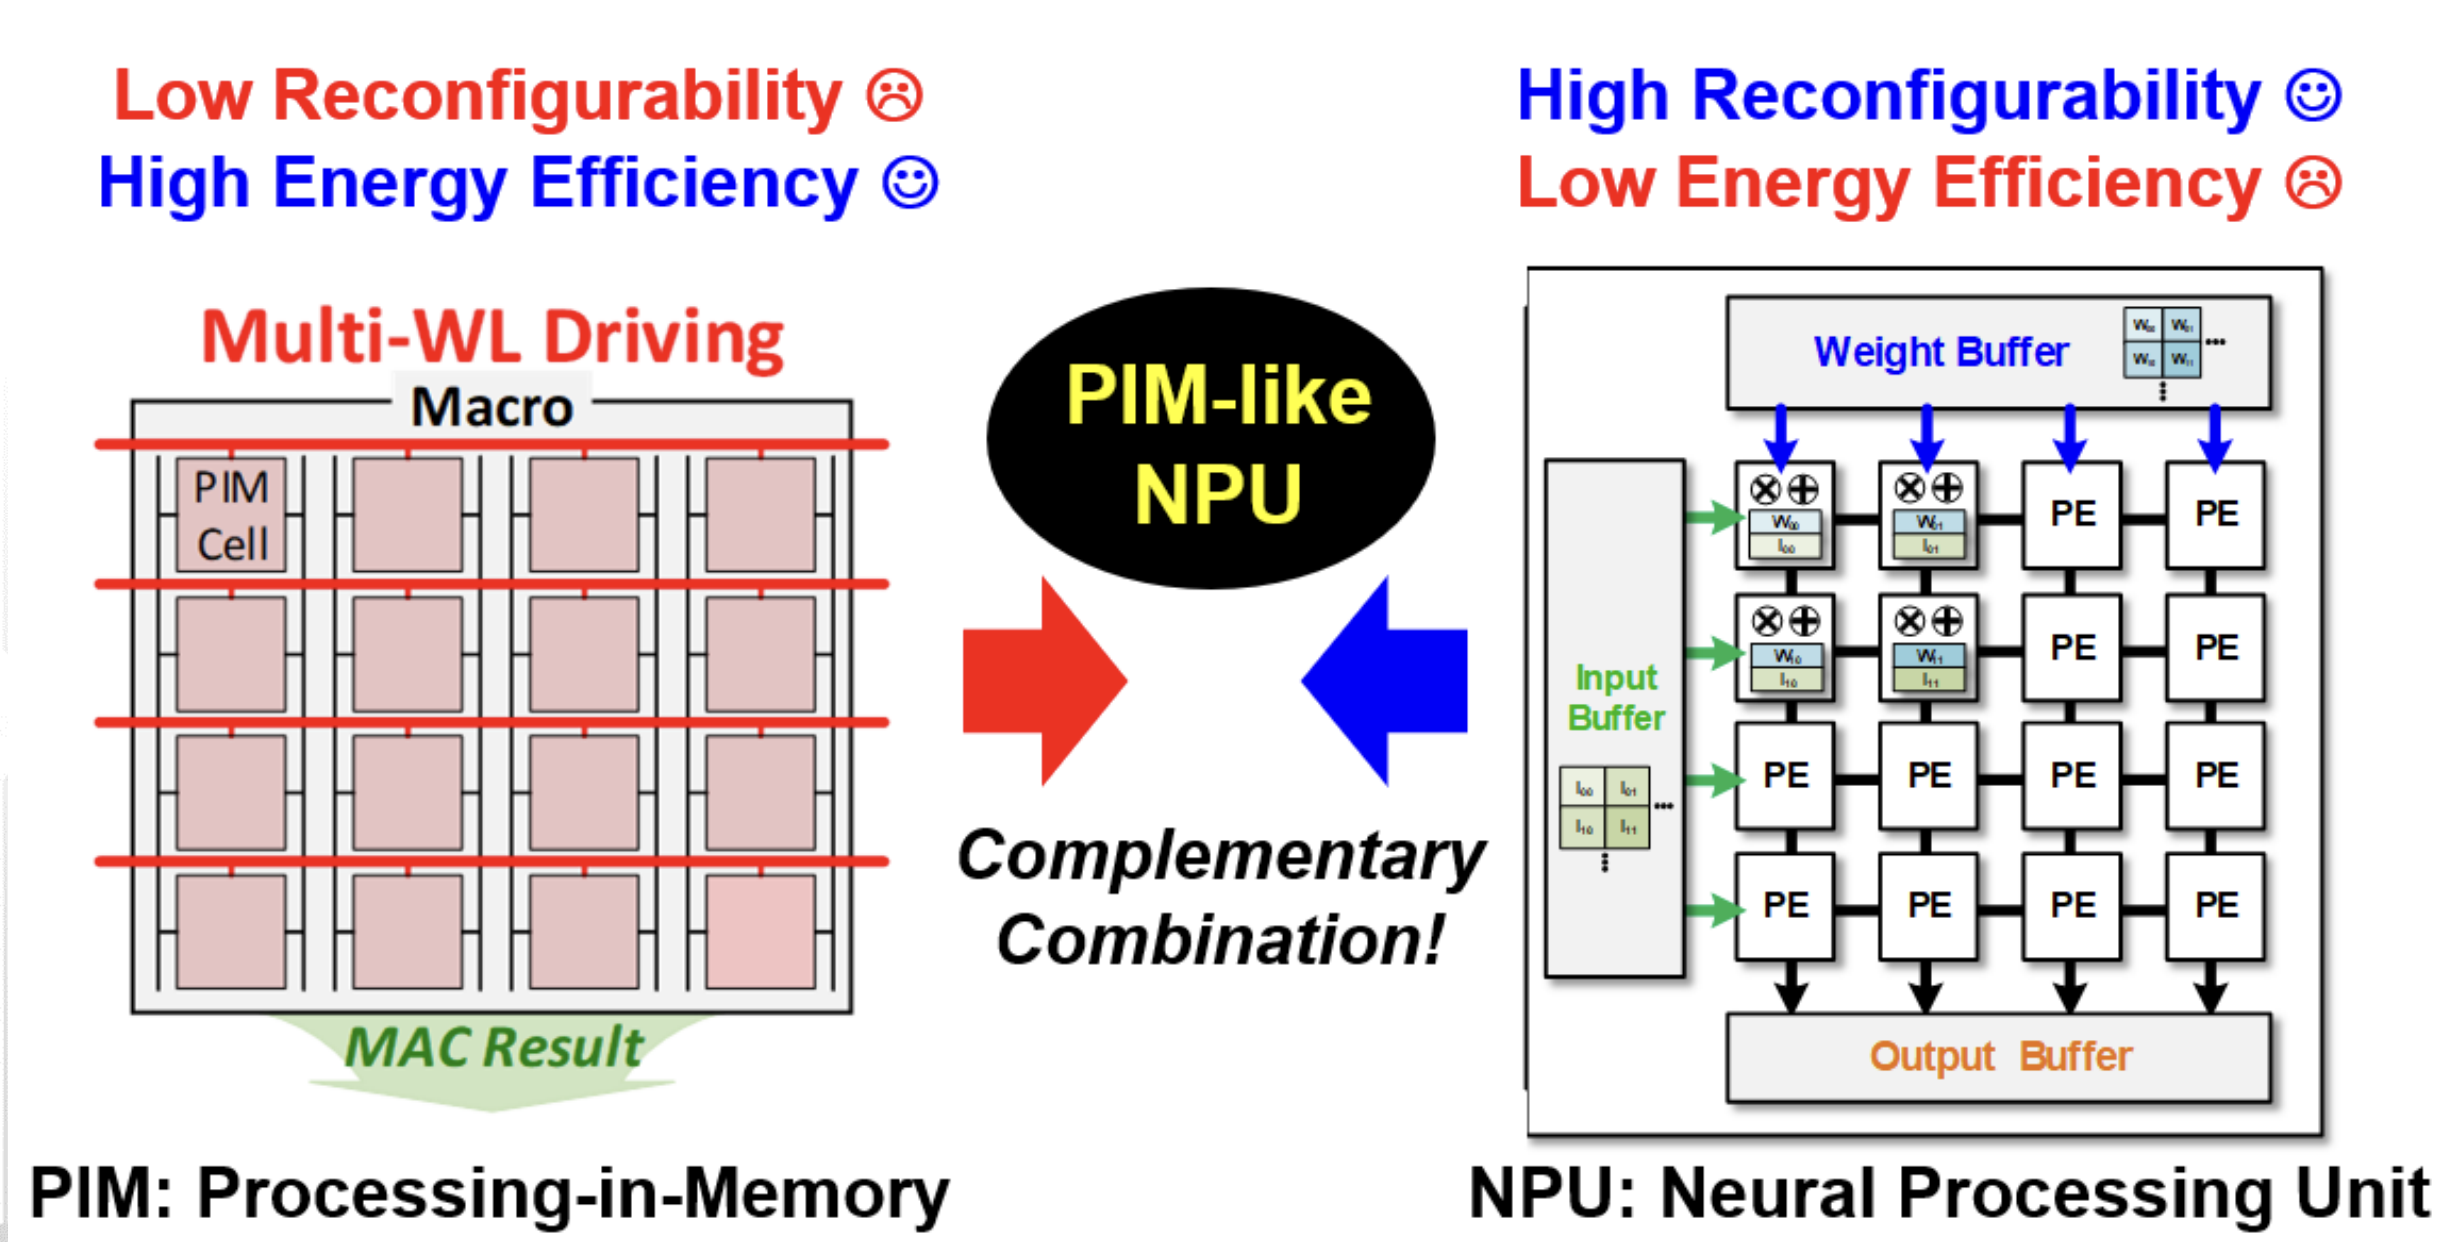
PIM의 에너지 효율과 NPU의 재구성성을 결합한 PIM-like NPU 개념도

모델의 요구에 맞춰 구성하는 NPU IP

PIM-like NPU IP는 세뮤나이트의 코어 기술입니다. 연산과 메모리를 가까이 배치하고, 모델의 요구에 맞춰 연산·데이터 이동·메모리 구성을 조합합니다.

Reconfigurable NPU
워크로드와 연산 정밀도에 맞춰 PE array와 멀티코어 구성을 연결합니다.
Data control
NPU 내부의 데이터 이동과 연산 실행을 제어합니다. CPU와 주변장치 연결은 이를 적용하는 칩·시스템에서 구성합니다.
Memory I/F
모델의 입력·가중치·출력을 위한 메모리 구조를 구성합니다. 외부 메모리 연결은 칩·시스템의 요구에 맞춰 설계합니다.
Domain Accelerators
SLM·Vision 확장을 위한 압축, Speculative decoding, Nonlinear function 가속을 준비합니다.

PIM(Processing-in-Memory)의 저전력 특성과 NPU의 높은 재구성성을 결합한 상호보완형 아키텍처입니다. EDA 툴의 자동 배치·배선에만 의존하지 않고, 수작업 기반 Physical Design으로 연산기와 메모리를 가까이 배치합니다. 데이터 이동 거리를 최소화해 에너지 소모, 연산 시간, 칩 면적을 함께 줄이는 PPA 최적화를 구현합니다.
SeM-V1 칩 구조와 스펙 보기

Zero-skipping으로 IP 고도화

0값과 관련된 불필요한 연산을 건너뛰는 기능을 NPU IP에 추가했습니다.

Zero-skipping 추가 · 테이프아웃 전

향후 VUI AI Chip 적용

업데이트된 IP는 향후 VUI AI Chip에 통합해 테이프아웃할 계획입니다.

VUI AI Chip 적용 · 테이프아웃 예정

기존 PIM-like NPU 검증용 SUAI 테스트 칩

SUAI

PIM-like NPU 검증용 테스트 칩

SUAI는 2026년 1월 테이프아웃을 완료하고, 2026년 6월 실칩을 수령했습니다.

Peak · INT8
3.3 TOPS @ 200 MHz
Peak · INT4
13.1 TOPS @ 200 MHz
NPU cores
32 NPU cores · 4 clusters × 8 cores
Process
Samsung 28nm

전체 32-core Peak 성능 · 200 MHz 기준입니다. INT8 연산은 INT4 array에서 4회에 나눠 처리합니다.

SUAI 구조와 코어별 PPA 보기
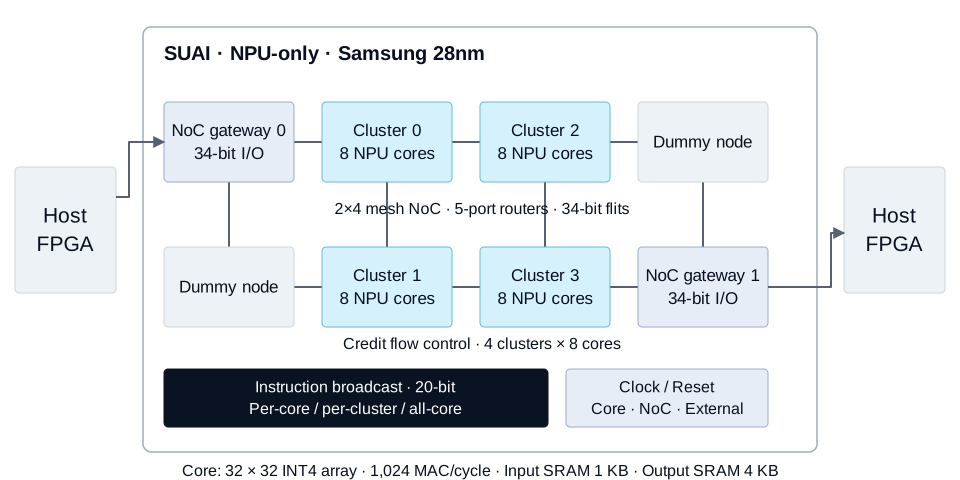
4 clusters × 8 cores, 2×4 mesh NoC로 구성한 NPU-only 테스트 칩입니다.
4 clusters × 8 cores, 2×4 mesh NoC로 구성한 NPU-only 테스트 칩입니다.도식 크게 보기 (새 탭)

SUAI 코어별 PPA

Peak / core · INT8
0.10 TOPS
Power / core
16.1 mW
Efficiency / core · INT8
6.4 TOPS/W
Area / core
0.110 mm²

PIM-like array block의 코어별 Peak 수치이며 I/O SRAM을 제외합니다. Synopsys PrimeTime PX, P&R netlist·Gate-level sim activity, 200 MHz, SS 0.9 V / −40 °C, MAC 활용률 100%, SPEF 미반영 조건입니다.

모델 적용에서 실행까지

NPU IP를 SeM-V1에 적용하는 AI SDK 개발 흐름의 예시입니다. TFLite INT8 모델을 분석하고 NPU·RISC-V 실행을 연결합니다.

  1. Trained model

    TFLite INT8 모델 준비

  2. Analysis & mapping

    Layer·양자화 분석, NPU/RISC-V 분할과 4-core 스케줄

  3. C Runtime & Libraries

    NPU·DMA driver, Audio 전처리와 Host protocol

  4. Build

    RISC-V GCC로 ELF 생성

  5. Flash image

    ELF와 Weights를 QSPI Flash에 배치

Runtime 구성 보기
Host application / Host library
Host application과 Host library가 UART/I2C로 명령과 결과 패킷을 주고받습니다.
Audio pre-processing / Inference scheduler
512-point FFT와 Q15 log-mel 전처리, 4 NPU cores + RISC-V 스케줄링을 연결합니다.
Bare-metal Runtime / Boot ROM
Bare-metal Runtime에서 Boot ROM이 QSPI Flash의 ELF를 로드하고 NPU·DMA driver와 Flash weight streaming을 실행합니다.
Platform 살펴보기

NPU IP의 다음 방향

SLM과 Vision으로의 확장을 준비하고 있습니다.

SLM

준비 중

소형 언어모델의 온디바이스 실행을 위한 메모리 구조와 연산 최적화를 준비합니다.

Flash 기반 Weight streaming, HyperRAM 기반 KV cache, Weight compression과 Speculative decoding을 검토합니다.

개발 목표·검토 모델 보기
목표 모델 규모
0.5B-class
목표 처리량
20+ tokens/s
메모리 구성 방향
Flash + HyperRAM
검토 모델
Qwen2.5-0.5B, Qwen3-0.6B

Vision

준비 중

경량 Vision 모델을 위한 멀티코어 연산과 메모리·데이터 처리 확장을 준비합니다.

CNN·ViT Dataflow, Shared L2·Tiling, HyperRAM과 Camera interface를 검토합니다.

개발 목표·검토 모델 보기
목표 연산 성능
0.5–2 TOPS (INT8)
목표 처리량
30+ fps
메모리 구성 방향
Flash + HyperRAM
검토 모델
NanoDet, YOLOv8n, ShuffleNetV2, BlazeFace, MobileViT

위 수치는 향후 개발 목표이며, 모델·양자화·메모리·동작 조건에 맞춰 구체화합니다. 현재 NPU의 검증 수치는 SUAI 섹션에 별도로 표시합니다.

NPU IP 적용을 함께 검토합니다.

고객의 모델과 제품 요구사항을 들려주세요.

협업 문의